


Dans le flux constant d’informations hétérogènes qui sature aujourd’hui les infrastructures des organisations, l’indexation des documents s’impose comme une étape fondamentale pour transformer le désordre structurel en un système organisé, réactif et exploitable. Pour un DSI, l’enjeu dépasse la simple commodité de recherche ; il s’agit de résoudre la problématique du « Dark Data », ces masses de données non structurées dont l’entreprise ignore le contenu et la valeur. L’indexation des documents constitue la clé de voûte permettant de retrouver instantanément l’information critique, d’optimiser les processus métiers de bout en bout et de garantir une intégrité des données compatible avec les exigences décisionnelles modernes.
Un système documentaire sans indexation performante condamne les collaborateurs à une perte de productivité systémique, où le temps passé à localiser une ressource prime sur son exploitation réelle. Au-delà du gain de temps, l’indexation est le vecteur de la pertinence informationnelle. Elle permet de passer d’une logique de stockage passif à une logique de gestion dynamique du patrimoine immatériel. Dans une architecture logicielle moderne, elle agit comme un pont sémantique entre les documents bruts et les applications métier, assurant que chaque unité de contenu devient une donnée structurée, interopérable et valorisable au sein du SI global.
La réussite d’une stratégie d’indexation conditionne également la réussite des projets d’intelligence artificielle générative et d’automatisation. Un moteur d’indexation défaillant ou imprécis induit mécaniquement des biais dans les algorithmes de traitement et réduit à néant les bénéfices attendus de la transformation numérique. Ainsi, pour le DSI, l’indexation doit être abordée non pas comme une fonctionnalité accessoire de la Gestion Électronique de Documents, mais comme une infrastructure de données critique, nécessitant une conception rigoureuse, des choix technologiques éclairés et une gouvernance stricte pour garantir la précision des résultats sur le long terme.
| Découvrez-en plus sur la GED |
Définition et principes de l’indexation des documents
1. Qu’est-ce que l’indexation des documents ?
L’indexation des documents se définit techniquement comme le processus systématique consistant à associer des informations descriptives, communément nommées métadonnées ou descripteurs, à un document ou à une unité d’information. Cette démarche vise à faciliter sa classification, son stockage dans des bases de données optimisées et sa récupération ultérieure via des requêtes complexes. Ces métadonnées peuvent être de nature diverse :
- Données descriptives : Éléments factuels de base tels que les titres, les formats ou les dates de création.
- Données administratives : Informations de gouvernance incluant le nom de l’auteur, les droits d’accès ou le service émetteur.
- Données sémantiques : Mots-clés et concepts extraits directement du contenu textuel grâce à des procédés d’analyse lexicale automatisée.
L’objectif ultime de ce processus est de conférer au document une forme d’intelligence embarquée. En enrichissant un fichier binaire avec une couche de métadonnées structurées, on permet une recherche multicritère qui s’affranchit des limites de la simple arborescence de dossiers. Le document n’est plus uniquement localisé par son emplacement physique ou son chemin d’accès numérique, mais par son identité propre et ses attributs contextuels. Cette transformation permet d’interroger le système d’information non plus seulement sur « où se trouve le fichier », mais sur « quels documents traitent de tel sujet, pour tel client, sur telle période », offrant ainsi une granularité d’accès indispensable à la performance opérationnelle.
Pour un décideur technique, l’indexation des documents est l’acte fondateur qui permet de lier l’immatériel (le texte, l’image) au relationnel (la base de données). C’est un processus d’extraction de sens qui doit être conçu pour répondre aux besoins actuels mais aussi aux usages futurs. Une indexation bien calibrée permet de maintenir un lien cohérent entre des documents produits par des services différents mais concourant à un même processus métier, créant ainsi une vue transversale et unifiée de l’information au sein de l’entreprise.
2. Les principes fondamentaux d’une bonne indexation
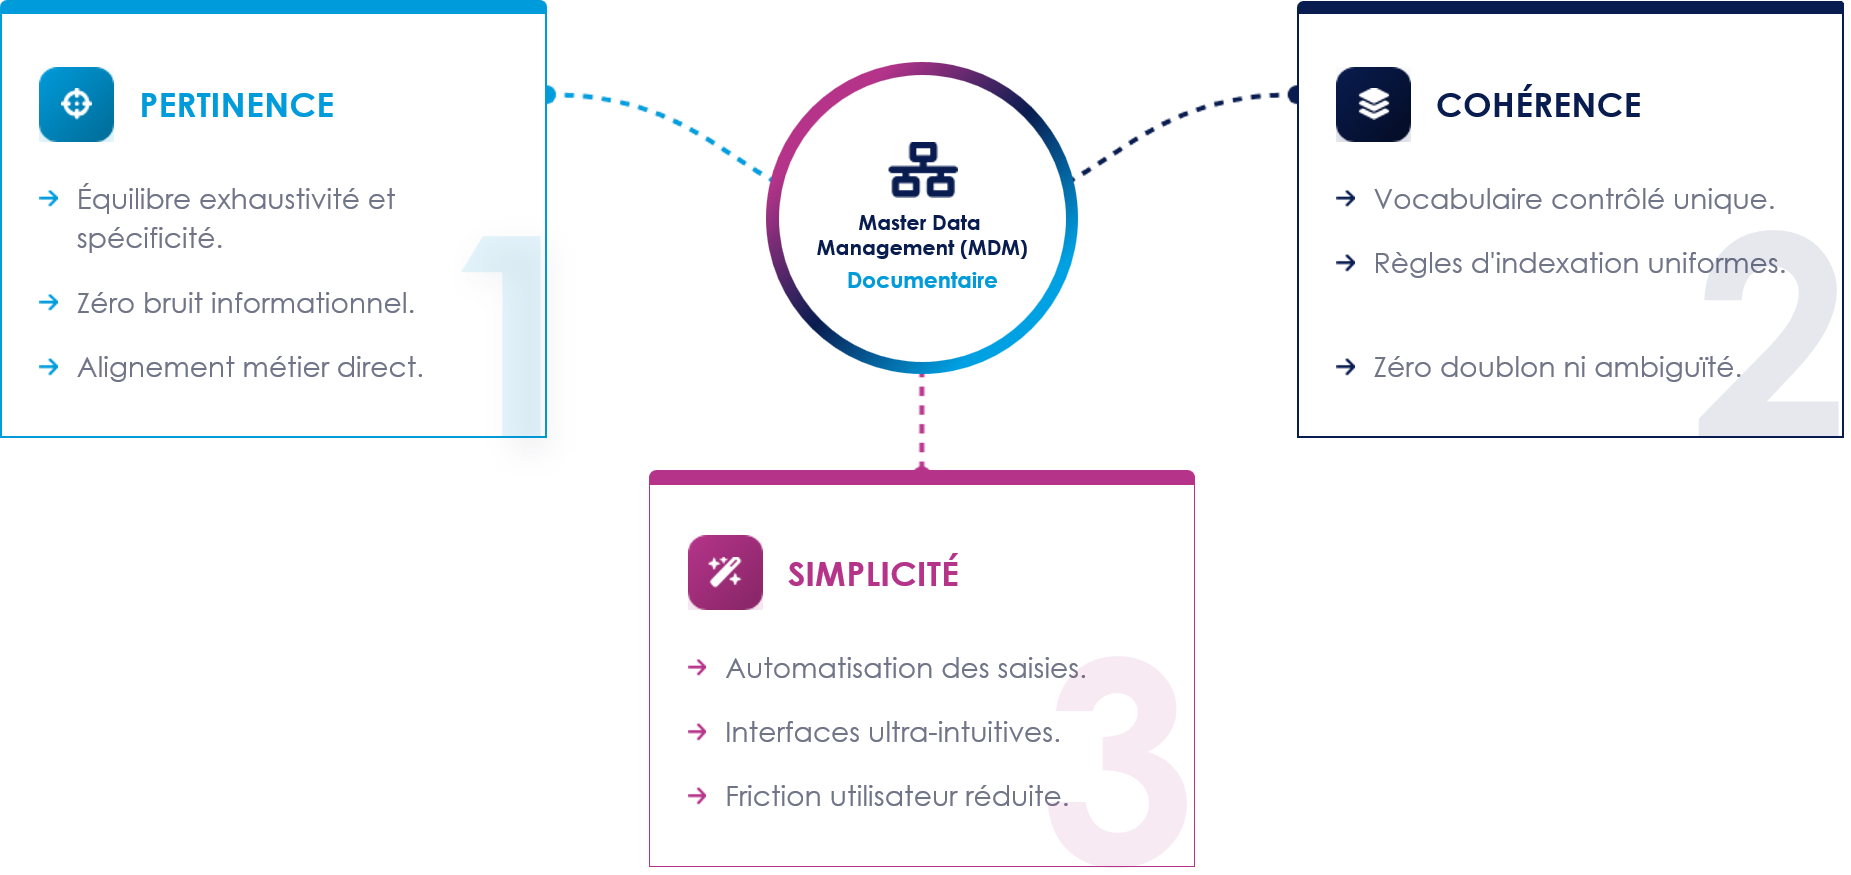
Une bonne indexation documentaire repose sur trois piliers :
3. Indexation manuelle vs. Indexation automatique
L’indexation manuelle repose sur l’intervention directe d’un opérateur humain qui analyse le document pour lui attribuer des descripteurs. Si cette méthode offre une précision intellectuelle et une finesse d’interprétation contextuelle inégalées, elle souffre de limites structurelles majeures pour les organisations modernes. Son caractère chronophage et son coût unitaire élevé la rendent inadaptée au traitement de gros volumes. De plus, elle est intrinsèquement sujette à la variabilité humaine : deux individus peuvent indexer différemment le même document, créant des incohérences qui nuisent à la fiabilité globale de la base documentaire. Elle doit donc être réservée aux documents à très haute valeur stratégique nécessitant une analyse sémantique fine.
À l’opposé, l’indexation automatique mobilise des technologies avancées telles que la Reconnaissance Optique de Caractères (OCR), la Lecture Automatique de Documents (LAD) et des algorithmes d’intelligence artificielle pour extraire et attribuer des métadonnées sans intervention humaine. Cette approche offre une vélocité de traitement indispensable pour absorber les flux de données massifs des entreprises contemporaines. L’automatisation garantit une parfaite uniformité dans l’application des règles d’indexation, éliminant les biais subjectifs. Toutefois, elle peut parfois manquer de discernement face à des documents atypiques ou des structures de données complexes, nécessitant une phase d’apprentissage ou des modèles de classification robustes.
L’approche hybride représente aujourd’hui le standard d’excellence pour une direction des systèmes d’information. Elle combine :
- la puissance de calcul de l’automatisation pour la capture de la majorité des flux informationnels
- la phase de validation ou d’enrichissement manuel pour les cas litigieux ou les documents critiques.
Ce modèle « Human-in-the-loop » permet de bénéficier de la rapidité de la technologie tout en conservant le contrôle qualité indispensable. Le système automatique effectue le travail de tri et d’extraction primaire, tandis que l’expert métier intervient uniquement pour arbitrer les incertitudes ou affiner les métadonnées stratégiques, optimisant ainsi les ressources humaines et techniques de l’organisation.
Méthodes et critères pour une indexation efficace
1. Indexation des documents par classification thématique
L’organisation des documents selon une classification thématique consiste à structurer les ressources selon des catégories et sous-catégories prédéfinies, basées sur le sujet traité ou la fonction métier du document. Cette méthode s’apparente à la construction d’une taxonomie organisationnelle où chaque élément trouve sa place dans une hiérarchie logique, par exemple en distinguant :
- les flux de facturation,
- les contrats de ressources humaines
- les dossiers de projets marketing.
Pour les utilisateurs, cette approche est particulièrement intuitive car elle calque souvent la réalité structurelle et opérationnelle de l’entreprise, facilitant une navigation fluide dans les dossiers virtuels.
Toutefois, une classification purement thématique montre ses limites lorsqu’un document appartient à plusieurs contextes simultanément. C’est pourquoi elle doit être conçue de manière flexible, en évitant les hiérarchies trop profondes qui enterrent l’information sous de multiples strates. Une classification efficace doit être dynamique et capable d’évoluer avec les métiers.
Pour le DSI, l’enjeu est de définir des « classes » de documents robustes au niveau de l’architecture de la GED, permettant d’appliquer automatiquement des politiques de sécurité et de rétention spécifiques à chaque thème, transformant la classification en un véritable outil de pilotage de la conformité.
2. Indexation des documents par métadonnées structurées
L‘indexation des documents par métadonnées structurées constitue la méthode la plus puissante pour garantir une recherche granulaire et précise. Elle repose sur l’attribution de champs d’information standardisés et typés à chaque document, tels que :
- la date de création,
- l’identifiant client,
- le code projet,
- le service émetteur,
- le statut de validation.
Contrairement à la simple recherche de mots-clés, les métadonnées structurées permettent de manipuler le document comme une ligne de base de données. On peut ainsi effectuer des calculs de durées, des filtrages par plages de montants ou des tris chronologiques complexes, offrant une dimension analytique indispensable à la gestion documentaire moderne.
Pour maximiser l’efficacité de cette méthode, l’utilisation de listes de valeurs contrôlées ou de dictionnaires de termes est impérative. En limitant les choix de l’utilisateur ou du système à des référentiels prédéfinis, on élimine les fautes de frappe et les variations de terminologie qui rendent la recherche inefficace.
Ces métadonnées structurées permettent également d’établir des liens de parenté entre les documents : une facture sera ainsi liée à son bon de commande et à son contrat-cadre via une métadonnée commune « Numéro de Dossier ».*
Cette interconnexion des données permet de reconstituer instantanément le contexte complet d’une affaire, apportant une valeur ajoutée métier considérable par rapport à une simple gestion de fichiers isolés.
3. Indexation des documents par mots-clés et recherche plein texte
L’indexation par mots-clés, souvent plus libre que les métadonnées structurées, permet d’assigner des termes descriptifs variés qui capturent l’essence d’un document sans s’enfermer dans une structure rigide. Elle est particulièrement utile pour les documents non structurés dont le contenu est imprévisible.
De son côté, la recherche plein texte (ou full-text search) indexe l’intégralité du contenu textuel d’un fichier. Grâce à des moteurs d’indexation performants comme Elasticsearch ou Lucene, il devient possible de retrouver une information précise basée sur n’importe quel terme présent dans le corps du document, même s’il n’a pas été explicitement identifié comme métadonnée lors de la phase de capture.
Cependant, la recherche plein texte ne doit pas être considérée comme un substitut à l’indexation structurée. Bien que puissante, elle génère souvent un bruit considérable, renvoyant des documents où le terme recherché apparaît de manière anecdotique ou hors contexte.
Pour le DSI, la stratégie gagnante réside dans la complémentarité : les métadonnées structurées fournissent le cadre et le filtre primaire (par exemple, filtrer sur les contrats de 2023), tandis que la recherche plein texte permet d’affiner la sélection en isolant une clause spécifique à l’intérieur de ces documents. Cette approche hybride garantit à la fois la rigueur de la structure et la flexibilité de l’exploration de données, répondant ainsi à l’ensemble des cas d’usage des collaborateurs.
Les outils et technologies d’indexation automatique
| Technologies | Rôle | Évolutions technologiques | Bénéfices |
| OCR | Convertir l’image scannée d’un document papier en texte éditable et interrogeable. Constitue le socle de la dématérialisation. | Amélioration du traitement des documents dégradés et les polices de caractères atypiques. | Rend les documents lisibles par les algorithmes. Transforme un fichier « poids mort » en donnée exploitable.
Intégrer l’outil au plus près de la capture, conserver la mise en page et garantir un format d’archivage. |
| RAD&LAD | RAD : Identifier automatiquement la typologie du document (ex: facture vs contrat).
LAD : Extraire les données spécifiques (TVA, montants) post-identification. |
Transition des anciens modèles à « zones de lecture rigides » vers des approches IA capables de gérer des mises en page hétérogènes. | Suppression de la saisie manuelle, accélération des délais de traitement, fiabilisation des données vers le CRM ou le système comptable.
Définir des mécanismes de contrôle (confidence scores) pour déclencher une vérification humaine uniquement si la certitude est sous un seuil défini. |
| IA & Machine Learning | Analyser sémantiquement les documents complexes ou non structurés (extraction de concepts plutôt que de chaînes de caractères). | Modèles de langage (NLP/LLM) permettant l’apprentissage continu via les corrections utilisateurs et l’interrogation en langage naturel. | Suggestion proactive de métadonnées, détection d’anomalies ou de non-conformités (ex: pièce périmée, clause manquante).
Faire de l’IA une norme pour valoriser le patrimoine documentaire et transformer la recherche en une véritable expérience de dialogue. |
Avantages d’une indexation des documents performante
1. Gain d’efficacité et de productivité
L’avantage le plus immédiat d’une indexation des documents rigoureuse est la réduction drastique du temps consacré à la recherche d’informations. Grâce à des moteurs de recherche puissants s’appuyant sur des index précis, l’accès à la ressource documentaire devient quasi instantané. Dans de nombreuses organisations, on estime qu’une indexation performante permet de réduire le temps de recherche de plus de 80 %, libérant ainsi des ressources précieuses pour des tâches à plus haute valeur ajoutée. Cette réactivité est un facteur clé de différenciation opérationnelle, permettant aux collaborateurs de répondre plus rapidement aux sollicitations des clients ou aux impératifs de production.
L’automatisation des processus métier est le second bénéfice majeur découlant d’une indexation de qualité. Lorsque les documents sont indexés automatiquement dès leur entrée, ils peuvent alimenter directement les workflows de validation sans rupture de charge. Une facture indexée par LAD peut ainsi être rapprochée automatiquement du bon de commande correspondant et mise en paiement en quelques minutes, là où un processus manuel prendrait plusieurs jours. En minimisant les interventions humaines, on réduit également les fautes de frappe et les erreurs de classement, garantissant une fiabilité des données qui se répercute sur l’ensemble de la chaîne de valeur et améliore la satisfaction globale des parties prenantes.
2. Amélioration de la sécurité et de la conformité
Une indexation précise constitue un levier de sécurité et de confidentialité extrêmement puissant :
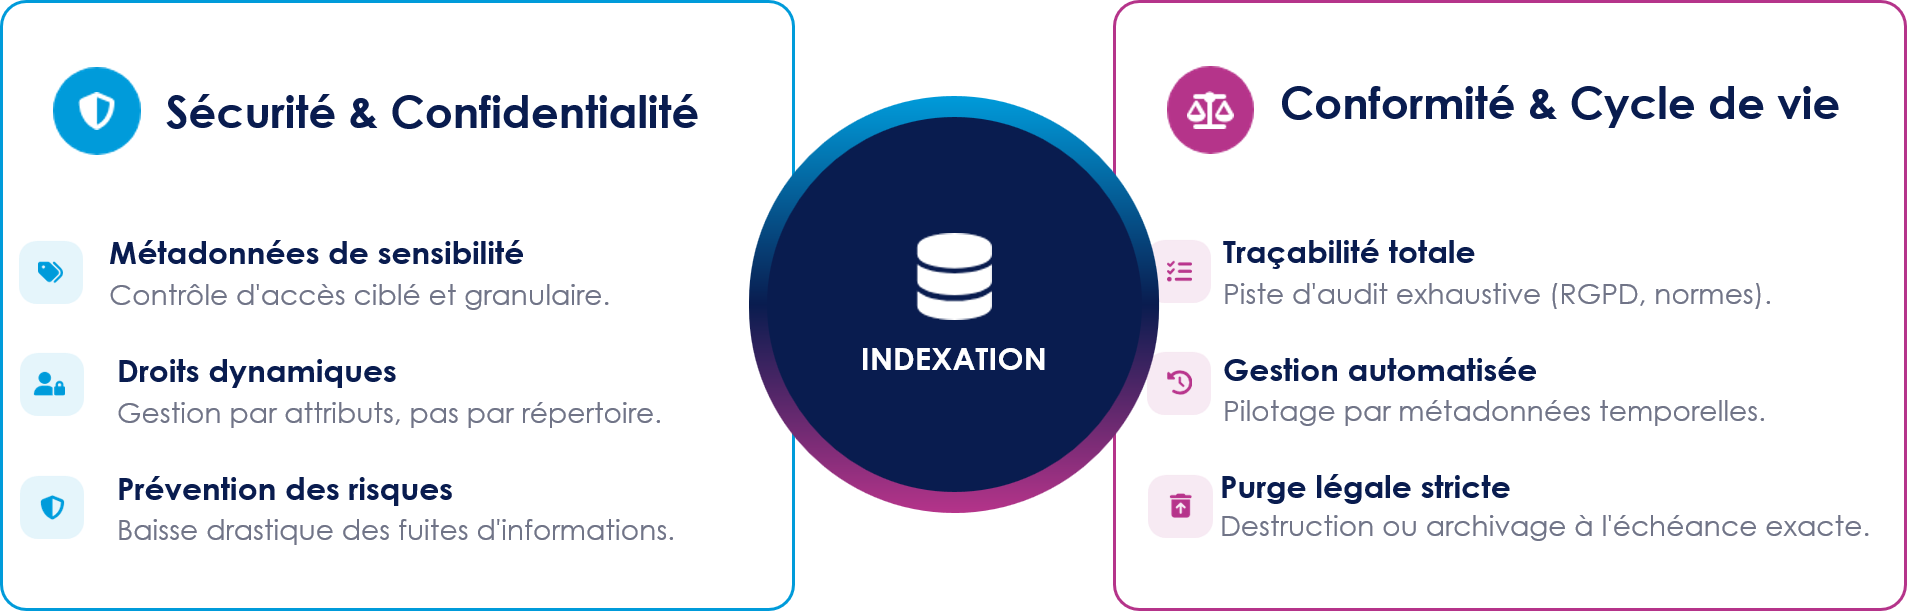
3. Valorisation des informations et meilleure prise de décision
Une indexation des documents performante transforme les documents bruts en données structurées prêtes à être exploitées par les outils décisionnels. Le patrimoine documentaire n’est plus un coût de stockage, mais devient une véritable source d’intelligence stratégique :
- Agrégation des données clés : Les informations extraites (montants, dates, noms de produits, typologies de clients) alimentent directement les analyses et les reportings.
- Pilotage en temps réel : Création de tableaux de bord permettant de suivre l’activité de manière instantanée.
- Aide à la direction : Offre une vision plus précise de l’activité globale pour faciliter les choix stratégiques.
- Optimisation des processus : Permet d’identifier rapidement les tendances émergentes ou de détecter les goulots d’étranglement opérationnels.
La capitalisation de la connaissance est un autre atout majeur de cette démarche. En organisant le savoir-faire de l’entreprise via une indexation sémantique cohérente, on facilite le partage d’expérience et l’innovation collaborative à travers toute l’organisation :
- Accessibilité de l’expertise : Les experts retrouvent facilement les rapports techniques, études de cas et schémas réalisés par d’autres services.
- Gain d’efficacité : Évite la duplication des efforts et empêche les équipes de « réinventer la roue » à chaque nouveau projet.
- Décisions éclairées : La prise de décision devient plus rapide, mieux documentée et plus pertinente grâce à cette agilité informationnelle.
- Réactivité accrue : L’entreprise s’adapte beaucoup plus vite aux évolutions imprévisibles du marché et aux exigences croissantes des clients.
L’indexation des documents, le cœur intelligent de la GED
L’indexation des documents ne doit plus être perçue comme une simple étiquette apposée sur un fichier, mais comme la pierre angulaire d’une gestion documentaire moderne, performante et sécurisée. En transformant des flux bruts de documents non structurés en informations structurées, intelligentes et immédiatement exploitables, elle permet aux entreprises de franchir un cap décisif en matière d’excellence opérationnelle. Pour le DSI, investir dans une stratégie d’indexation de haut niveau, s’appuyant sur des technologies d’IA et des référentiels de métadonnées rigoureux, est le meilleur moyen de garantir que le système d’information reste un atout au service du métier plutôt qu’une charge administrative.
En dernière analyse, l‘indexation des documents est le mécanisme par lequel l’organisation reprend le contrôle de son patrimoine informationnel. Elle assure la jonction indispensable entre la technologie et l’humain, en rendant l’information non seulement disponible, mais surtout compréhensible et valorisable. Dans un contexte où la donnée est le carburant de l’économie numérique, la maîtrise de l’indexation est un impératif stratégique pour toute organisation visant la résilience et l’agilité. Elle constitue le cœur intelligent de la GED, le moteur qui propulse l’entreprise vers une gestion de l’information proactive, auditable et créatrice de valeur durable.
| Besoin de conseils ? Contactez-nous |
Commentaires récents